Charly Marie
  • Home
  • Research
  • Behavioural science
  • Academic teaching
  • Seminars
  • CV
  • Blog

Sur cette page

  • Point de départ
  • Reproduire le graphique
    • Préparer les données
      • Extraire les données
      • Pivoter le jeu
    • Préparer le graphique
      • Poser la structure
      • Ajouter les textes : titre, sous-titre et caption
      • Placer et ordonner la légende
      • Retirer les titres d’axes et renommer les sujets
      • Colorer et afficher les pourcentages
      • Régler le thème et les dimensions
  • Conclusion
  • Références

Reproduire un graphique du Monde, en utilisant ggplot2

  • Montrer tout le code
  • Cacher tout le code

  • Voir les sources
R
Figure
ggplot2
Les infographies du Monde sont efficaces. Reproduisons l’une d’elles, étape par étape, en ggplot2.
Date de publication

16 octobre 2026


Point de départ

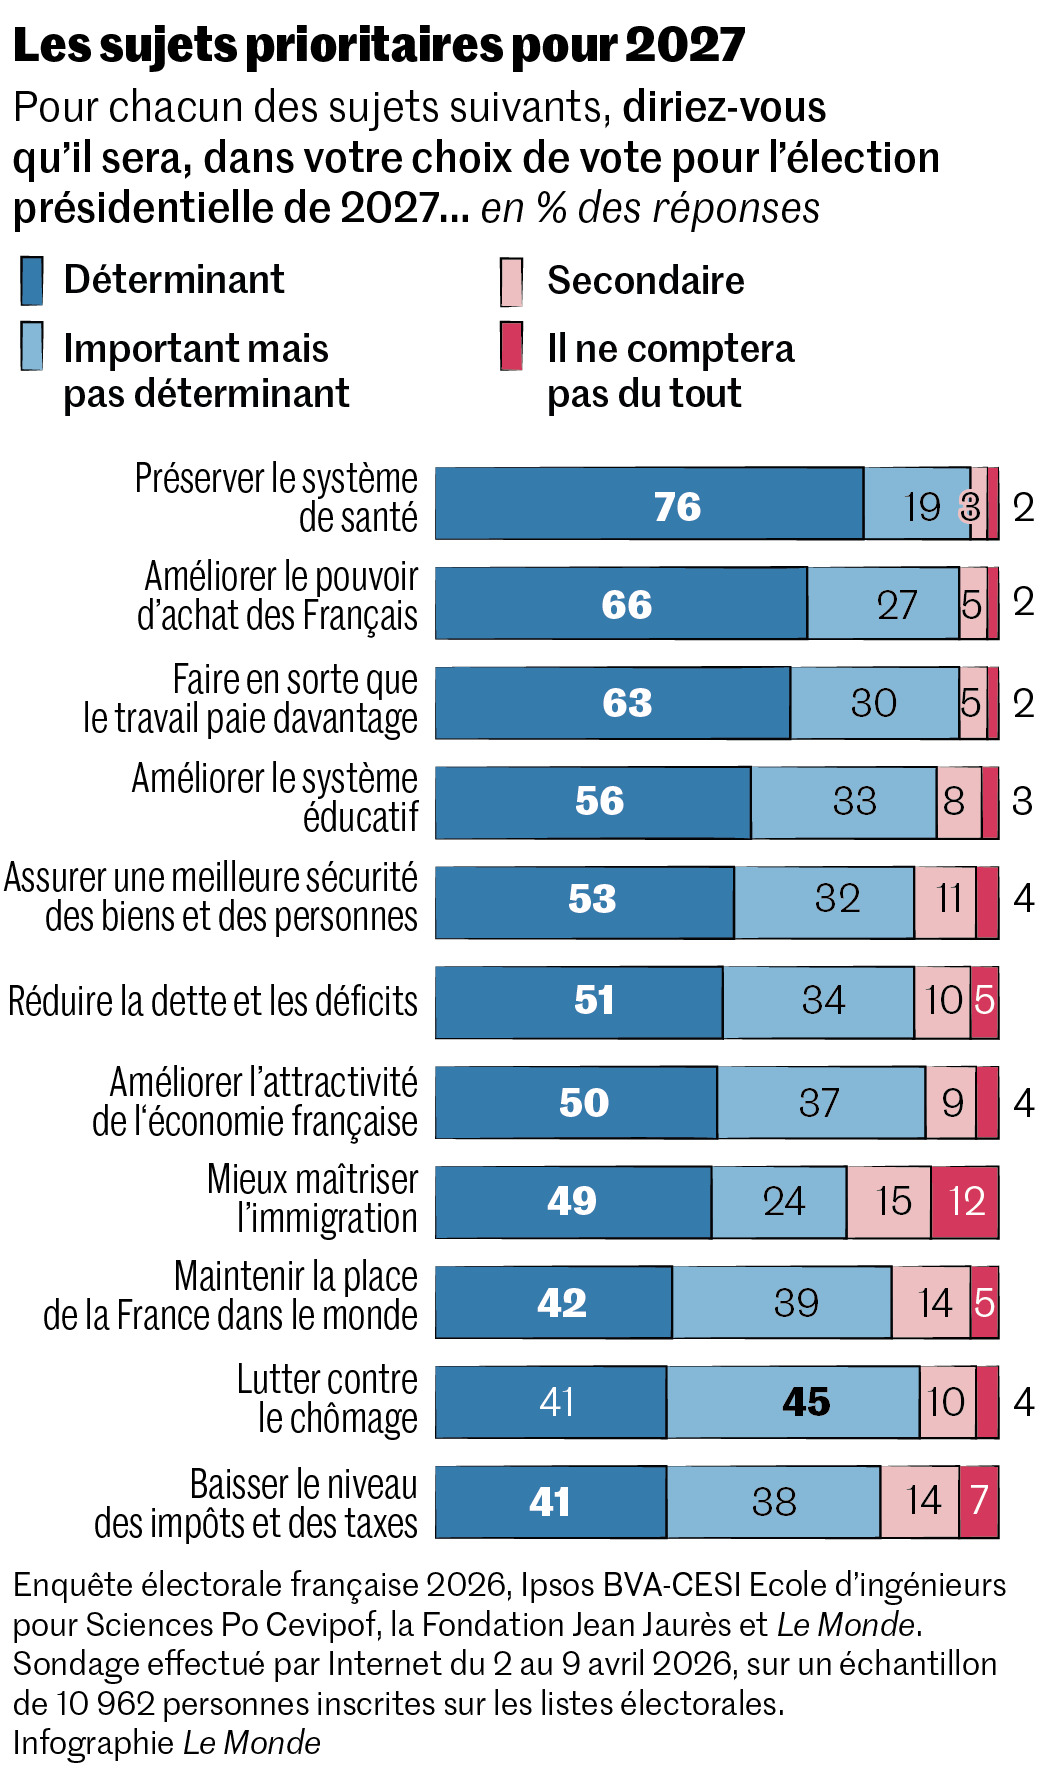
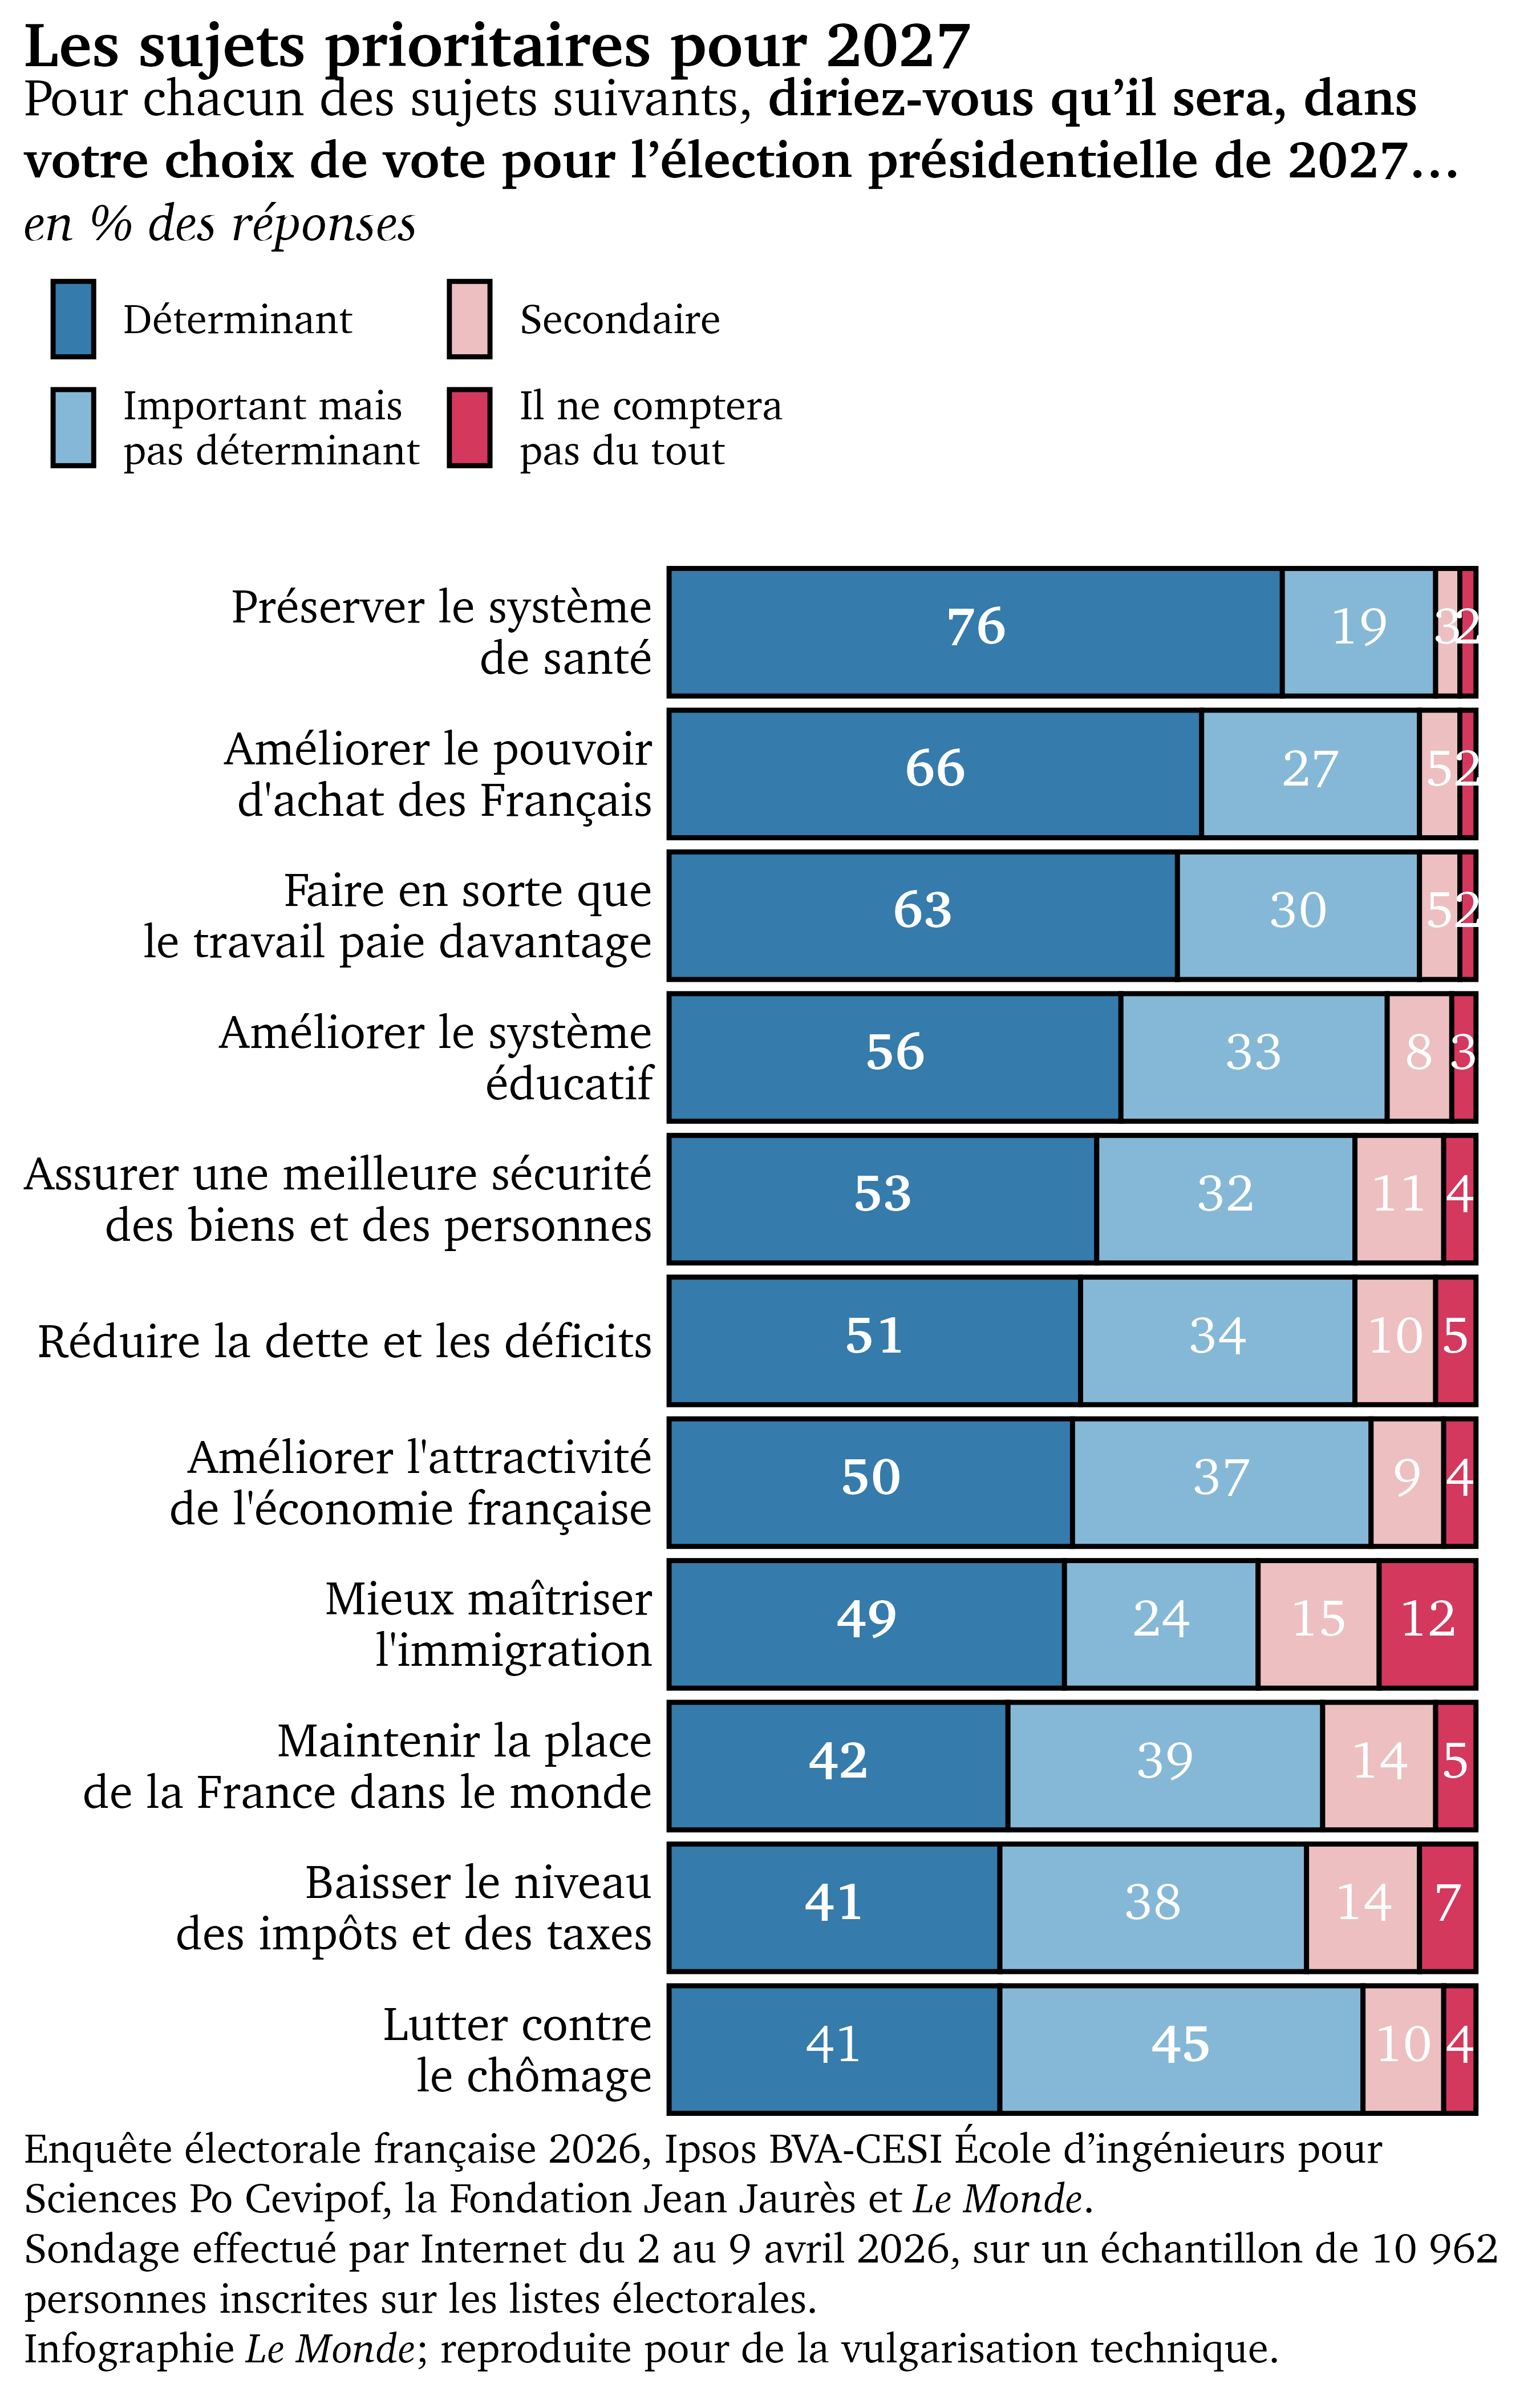
Les graphistes du Monde sont très fortiches, en réalisant de belles représentations graphiques de données autrement relativement indigestes. Par exemple, l’article Présidentielle 2027 : la santé et le pouvoir d’achat, principales préoccupations des électeurs à un an du scrutin représente des résultats issus d’une enquête électorale auprès de 10 962 personnes sur les thèmes prioritaires pour l’élection présidentielle de 2027.

Le premier graphique de cet article est le suivant :

Figure 1: Les sujets prioritaires pour la présidentielle de 2027, selon l’enquête électorale Ipsos BVA-CESI École d’ingénieurs, mise en forme par Le Monde.

Je sais pas vous, mais moi, je le trouve efficace. Donc, on va essayer de le reproduire en R, étape par étape.

Pour chaque étape, l’idée est de reproduire le graphique, même si les proportions ne sont pas bonnes. On gérera les dimensions à la toute dernière étape.

Reproduire le graphique

Préparer les données

Extraire les données

La première étape est de disposer des données. Ici, rien de bien compliqué. On regarde ligne après ligne, et on en fait un tribble1.

Voir le code
library(tidyverse) # le package tibble fait partie du tidyverse
library(knitr) # pour afficher les données en une table

# Extraire les données
sujets_2027 <- tribble(
  ~sujet, ~determinant, ~important_pas_determinant, ~secondaire, ~ne_comptera_pas,
  "sante", 76, 19, 3, 2,
  "pouvoirdachat", 66, 27, 5, 2, 
  "travailpaie", 63, 30, 5, 2,
  "systemeeducatif", 56, 33, 8, 3,
  "securite", 53, 32, 11, 4,
  "dette", 51, 34, 10, 5,
  "attractivite", 50, 37, 9, 4,
  "immigration", 49, 24, 15, 12,
  "place", 42, 39, 14, 5,
  "chomage", 41, 45, 10, 4,
  "impotstaxes", 41, 38, 14, 7
)

kable(sujets_2027) # afficher les données
sujet determinant important_pas_determinant secondaire ne_comptera_pas
sante 76 19 3 2
pouvoirdachat 66 27 5 2
travailpaie 63 30 5 2
systemeeducatif 56 33 8 3
securite 53 32 11 4
dette 51 34 10 5
attractivite 50 37 9 4
immigration 49 24 15 12
place 42 39 14 5
chomage 41 45 10 4
impotstaxes 41 38 14 7
Table 1: Le jeu de données messy ☹️.

On a les données, c’est très bien. Mais voilà, elles ne sont pas tidy (Wickham, 2014). Tidy, littéralement propre, rangé, est un format standardisé de données. L’idée est que des données tidy sont utilisables par ggplot2, à l’opposé de données messy (littéralement désordonnées, en bazar), qui ne le sont pas. Le format repose sur trois principes de base :

  1. Chaque variable est une colonne;
  2. Chaque observation est une ligne;
  3. Chaque type d’observation est une table.

Ici, une même variable (le pourcentage de réponses) se retrouve dans quatre colonnes différentes, chaque ligne n’est pas une observation mais les réponses par question, en bref, c’est le bazar, c’est messy, et on va le tidy.

Pivoter le jeu

Pour ce faire, on fait pivoter le jeu.

On en profite également pour fixer l’ordre des facteurs de façon décroissante, pour que le graphique affiche les données du plus gros au plus petit pourcentage plutôt que de façon alphabétique2.

Je n’affiche que les 15 premières lignes.

Voir le code
sujets_2027_long <- sujets_2027 %>%
  
  mutate(
    sujet = fct_reorder(
    sujet, 
    determinant
    )
  ) %>%  # arranger la colonne sujet, en fonction de la colonne determinant
  
  pivot_longer(
    cols = -sujet, # pas besoin de la faire pivoter, on la garde telle quelle
    names_to = "reponse", # les colonnes pivotées finissent ici
    values_to = "pct" # les valeurs pivotées finissent là
  )

sujets_2027_long %>%
  head(n = 15) %>% # afficher les 15 premières lignes
  kable()
sujet reponse pct
sante determinant 76
sante important_pas_determinant 19
sante secondaire 3
sante ne_comptera_pas 2
pouvoirdachat determinant 66
pouvoirdachat important_pas_determinant 27
pouvoirdachat secondaire 5
pouvoirdachat ne_comptera_pas 2
travailpaie determinant 63
travailpaie important_pas_determinant 30
travailpaie secondaire 5
travailpaie ne_comptera_pas 2
systemeeducatif determinant 56
systemeeducatif important_pas_determinant 33
systemeeducatif secondaire 8
Table 2: Le jeu de données tidy 😀.

Désormais, chaque variable est bien une colonne et chaque ligne est bien une observation. On peut travailler.

Préparer le graphique

Première étape, réfléchir en R et en ggplot2 (Wickham, 2016).

D’abord, R est un langage dit “orienté objet.” On va donc créer un objet (un plot), qui appellera lui-même des objets pour sa construction (le titre du plot, le sous-titre, etc…).

Ensuite, en grammaire ggplot2, les graphiques sont des couches, et il faut bien réfléchir à l’ordre dans lequel le code est écrit (pour que les couches se superposent dans le bon ordre).

Poser la structure

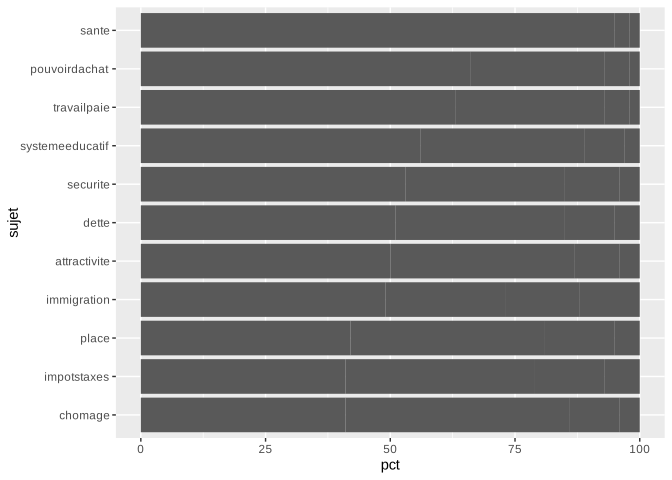
On pose un fond, en appelant la fonction, puis on définit notre usage de base, des petits bâtons, c’est-à-dire des colonnes.

Voir le code
sujets_2027_long %>% # partir des données
  
  ggplot() + # appeler ggplot()
  
  geom_col() + # définir un diagramme en barres
  
  aes(
    x = pct, # définir l'axe x en abscisse (le pourcentage de réponses) 
    y = sujet # définir l'axe y en ordonnée (la question posée)
  )
Figure 2: Le squelette : des colonnes grises, sans couleur ni texte. C’est pas grand chose, mais c’est un début.

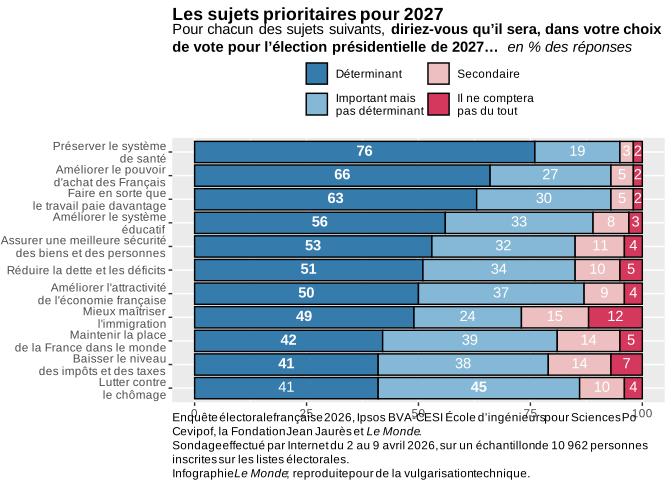
Voilà : les bases sont posées. Le seul problème structurel est la ligne Lutter contre le chômage, qui est en dernière, alors que c’est la ligne Baisser le niveau des impôts et des taxes dans la Figure 1 (les deux lignes sont à 41 % de réponses jugées Déterminantes).

Si on voulait une copie parfaitement conforme, on devrait ordonner les données manuellement plutôt qu’automatiquement. Ici, mon but est plutôt de suivre une logique d’automatisation, pour obtenir un graphique qui ordonne lui-même les réponses de façon descendante. Donc, je ne vais pas le modifier manuellement.

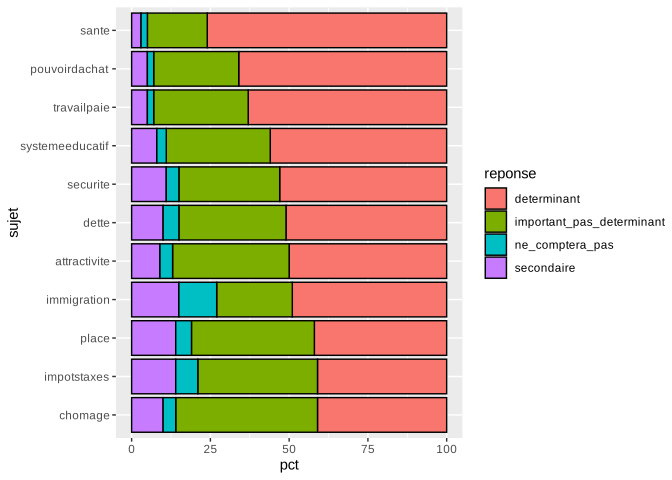
J’ajoute désormais deux choses. D’abord, la couleur, en fonction de la réponse donnée. Ensuite, chaque réponse donnée est entourée d’un liseré noir comme sur le graphique original.

Voir le code
sujets_2027_long %>%
  
  ggplot() +
  
  geom_col(
    colour = "black" # ajouter un liseré noir autour des colonnes
    ) +
  
  aes(
    x = pct, 
    y = sujet,
    fill = reponse # colorer les barres, en fonction des modalités de réponse
  )
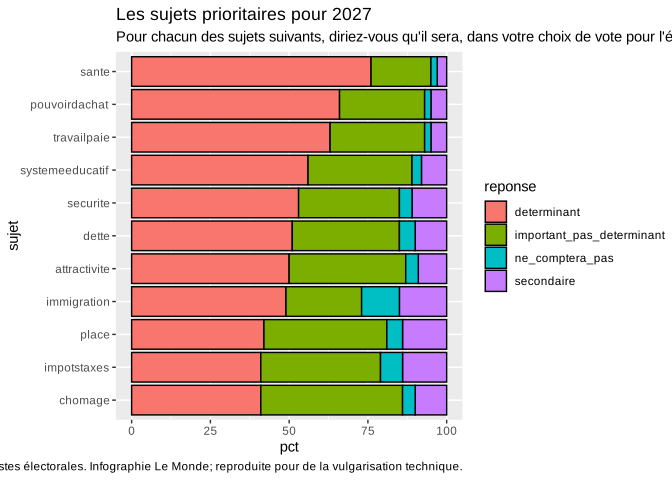
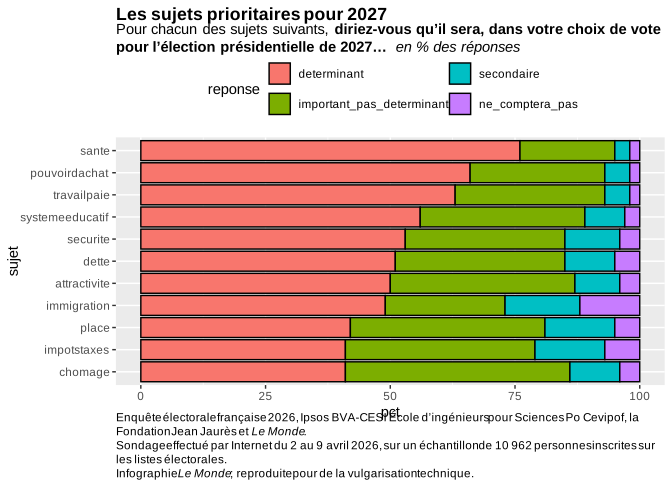
Figure 3: Couleur par modalité de réponse et liseré noir autour de chaque segment. Les modalités sont encore dans le mauvais ordre.

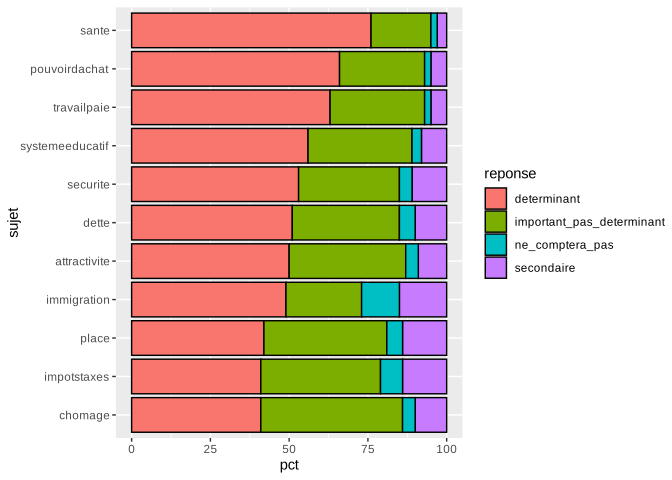
Premier problème, les modalités de réponse ne sont pas dans le bon ordre. Plutôt que d’arranger/ordonner le facteur, comme on l’a fait juste au-dessus, on va spécifier un argument précisant d’inverser l’ordre d’affichage des réponses.

Voir le code
sujets_2027_long %>%
  
  ggplot() +
  
  geom_col(
    position = position_stack(
      reverse = TRUE # reverse = TRUE est assez explicite
      ),
    colour = "black"
    ) +
  
  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  )
Figure 4: Les segments sont empilés dans l’ordre de la légende grâce à position_stack(reverse = TRUE).

Ajouter les textes : titre, sous-titre et caption

On ajoute le titre, sous-titre, la note, en respectant la logique d’objet de R. On voit qu’ils dépassent largement le cadre du plot. On solutionnera ça à la prochaine étape.

Voir le code
title_lemonde <- "Les sujets prioritaires pour 2027"
subtitle_lemonde <- "Pour chacun des sujets suivants, diriez-vous qu'il sera, dans votre choix de vote pour l'élection présidentielle de 2027... en % des réponses"
caption_lemonde <- "Enquête électorale française 2026, Ipsos BVA-CESI École d'ingénieurs pour Sciences Po Cevipof, la Fondation Jean Jaurès et Le Monde. Sondage effectué par Internet du 2 au 9 avril 2026, sur un échantillon de 10 962 personnes inscrites sur les listes électorales. Infographie Le Monde; reproduite pour de la vulgarisation technique."

sujets_2027_long %>%
  
  ggplot() +

  geom_col(
    position = position_stack(
      reverse = TRUE
      ),
    colour = "black"
    ) +
  
  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  )  +
  
  labs(
    title = title_lemonde, 
    subtitle = subtitle_lemonde,
    caption = caption_lemonde
  )
Figure 5: Titre, sous-titre et source ajoutés. Ils débordent du cadre, c’est réglé à l’étape suivante.

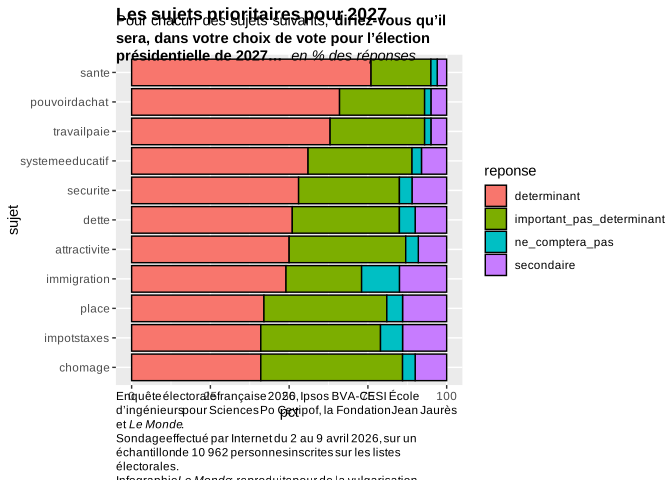
Désormais, il faut formater le sous-titre et le caption, qui incluent du gras et de l’italique. On va utiliser le package ggtext (Wilke & Wiernik, 2022), qui permet d’incorporer du markdown et du html dans les textes.

Cela va aussi résoudre le problème de longueur, en gérant automatiquement les renvois à la ligne.

Voir le code
library(ggtext)

title_lemonde_ggtext <- "**Les sujets prioritaires pour 2027**"
subtitle_lemonde_ggtext <- "Pour chacun des sujets suivants, **diriez-vous qu'il sera, dans votre choix de vote pour l'élection présidentielle de 2027...** *en % des réponses*"
caption_lemonde_ggtext <- "Enquête électorale française 2026, Ipsos BVA-CESI École d'ingénieurs pour Sciences Po Cevipof, la Fondation Jean Jaurès et *Le Monde*.<br>Sondage effectué par Internet du 2 au 9 avril 2026, sur un échantillon de 10 962 personnes inscrites sur les listes électorales.<br>Infographie *Le Monde*; reproduite pour de la vulgarisation technique."

sujets_2027_long %>%

  ggplot() +

  geom_col(
    position = position_stack(
      reverse = TRUE
      ),
    colour = "black"
    ) +

  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple()
  )
Figure 6: Retours à la ligne automatiques, gras et italique dans les textes avec ggtext. La légende est encore à droite.

Ce qui est entre une étoile est en italique, entre deux étoiles est en gras. Les balises <br> sont un retour à la ligne, en html, que ggplot2 ne reconnaît pas nativement (d’où l’utilisation de ggtext). Cela commence à globalement prendre forme.

Placer et ordonner la légende

La légende est mal positionnée, il nous faut la remonter au-dessus des réponses.

Voir le code
sujets_2027_long %>%

  ggplot() +
  
  geom_col(
    position = position_stack(
      reverse = TRUE
      ),
    colour = "black"
    ) +

  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(), 
    legend.position = "top" # Bien positionnée
  )
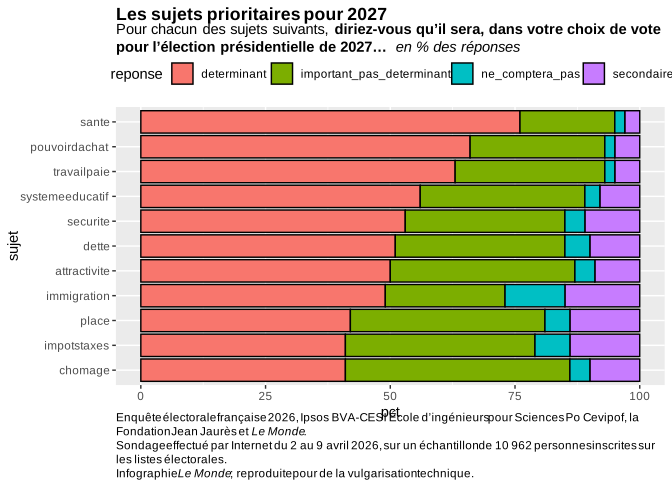
Figure 7: La légende passe au-dessus du graphique, sur une seule ligne.

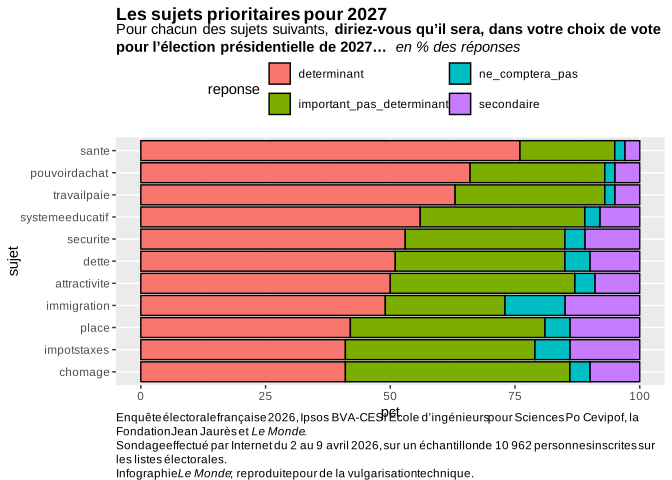
Cette légende est une ligne, on souhaite une grille 2x2.

Voir le code
sujets_2027_long %>%

  ggplot() +

  geom_col(
    position = position_stack(
      reverse = TRUE
      ),
    colour = "black"
    ) +
  
  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(), 
    legend.position = "top"
  ) +
  
  guides(
    fill = guide_legend(
      nrow = 2, 
      ncol = 2
    )
  )
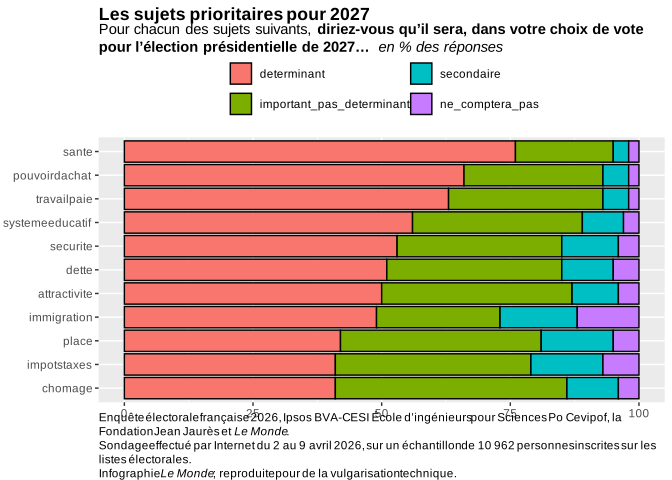
Figure 8: La légende est disposée en grille deux par deux. Presque : l’ordre des modalités ne suit pas encore celui des barres.

Problème supplémentaire, la légende n’est pas bien ordonnée. En R, les catégories sont par défaut présentées par ordre alphabétique. Il faut donc fixer l’ordre des facteurs.

Voir le code
sujets_2027_long %>%
  
  mutate(
    reponse = factor(
      reponse, 
      levels = c(
        "determinant",
        "important_pas_determinant",
        "secondaire",
        "ne_comptera_pas"
      )
    )
  ) %>%
  
  ggplot() +
  
  geom_col(
    position = position_stack(
      reverse = TRUE
      ),
    colour = "black"
    ) +
  
  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(), 
    legend.position = "top"
  ) +
  
  guides(
    fill = guide_legend(
      nrow = 2, 
      ncol = 2
      )
  )
Figure 9: Les niveaux du facteur reponse sont fixés : la légende suit enfin l’ordre des segments.

Retirer les titres d’axes et renommer les sujets

Étape suivante, le graphique initial ne nomme pas ses axes ou la légende. On les retire.

Voir le code
sujets_2027_long %>%
    
  mutate(
    reponse = factor(
      reponse, 
      levels = c(
        "determinant",
        "important_pas_determinant",
        "secondaire",
        "ne_comptera_pas"
      )
    )
  ) %>%

  ggplot() +
  
  geom_col(
    position = position_stack(
      reverse = TRUE
      ),
    colour = "black"
    ) +
 
  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(), 
    legend.position = "top",
    axis.title = element_blank(), # retirer les titres des axes
    legend.title = element_blank() # retirer le titre de la légende
  ) +
  
  guides(
    fill = guide_legend(
      nrow = 2, 
      ncol = 2
      )
  )
Figure 10: Titres des axes et de la légende retirés, comme sur l’original.

On commence à avoir, globalement, reproduit la structure de la figure initiale. Il manque beaucoup de choses cependant, comme la police d’écriture, les couleurs, renommer les labels en ordonnée, la position des titre, sous-titre et de la légende, le fond du plot… continuons donc par les labels en ordonnée.

À nouveau, en respectant la logique d’objet de R.

Voir le code
labels_lemonde <- c(
  sante = "Préserver le système\nde santé",
  pouvoirdachat = "Améliorer le pouvoir\nd'achat des Français",
  travailpaie = "Faire en sorte que\nle travail paie davantage",
  systemeeducatif = "Améliorer le système\néducatif",
  securite = "Assurer une meilleure sécurité\ndes biens et des personnes",
  dette = "Réduire la dette et les déficits",
  attractivite = "Améliorer l'attractivité\nde l'économie française",
  immigration = "Mieux maîtriser\nl'immigration",
  place = "Maintenir la place\nde la France dans le monde",
  chomage = "Lutter contre\nle chômage",
  impotstaxes = "Baisser le niveau\ndes impôts et des taxes"
)

sujets_2027_long %>%
  
  mutate(
    reponse = factor(
      reponse, 
      levels = c(
        "determinant",
        "important_pas_determinant",
        "secondaire",
        "ne_comptera_pas"
      )
    )
  ) %>%

  ggplot() +

  geom_col(
    position = position_stack(
      reverse = TRUE
      ),
    colour = "black"
    ) +
  
  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(), 
    legend.position = "top",
    axis.title = element_blank(),
    legend.title = element_blank()
  ) +
  
  guides(
    fill = guide_legend(
      nrow = 2, 
      ncol = 2
    )
  ) +
  
  scale_y_discrete(
    labels = labels_lemonde # modifier les labels en ordonnée, en respectant les retours à la ligne de la figure initiale
  )
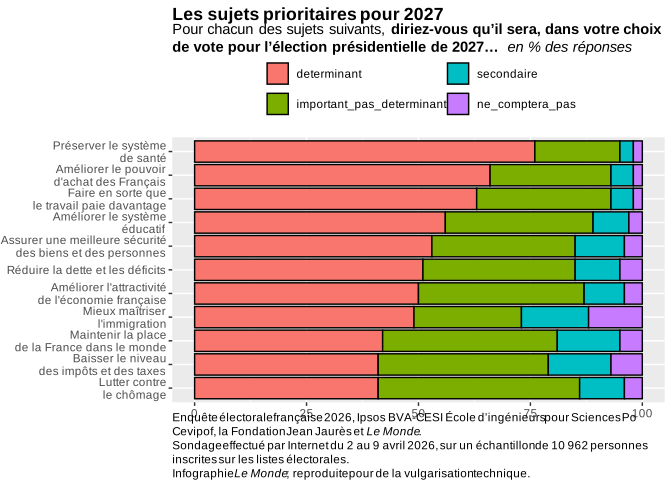
Figure 11: Les sujets en ordonnée reçoivent leur libellé complet, avec les mêmes retours à la ligne que Le Monde.

Les balises \n sont un retour à la ligne classique, que ggplot2 reconnaît nativement (contrairement à <br>, qui est un retour à la ligne en html).

Colorer et afficher les pourcentages

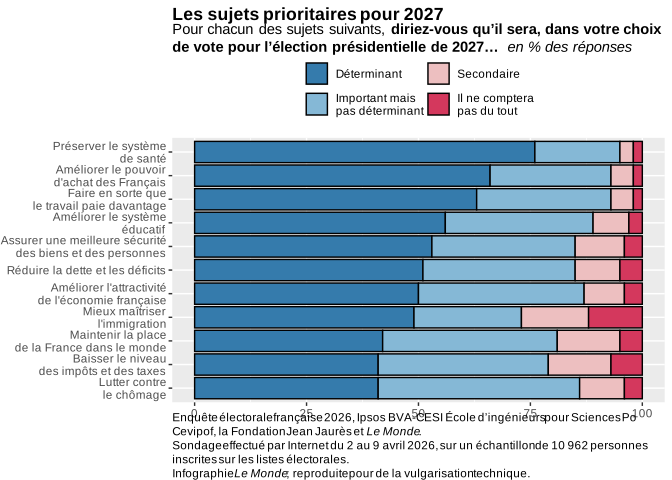
Toujours simple, les couleurs. Je m’aide de la pipette de Paint pour les identifier et les définir manuellement.

Aussi, les labels de la légende ne sont pas propres, il faut les modifier.

Voir le code
labels_lemonde_legende <- c(
  "Déterminant",
  "Important mais\npas déterminant",
  "Secondaire",
  "Il ne comptera\npas du tout"
)

scale_fill_lemonde <- c(
  "#357BAC",
  "#85B8D6",
  "#EDBFC0",
  "#D4385D"
  )

sujets_2027_long %>%
  
  mutate(
    reponse = factor(
      reponse, 
      levels = c(
        "determinant",
        "important_pas_determinant",
        "secondaire",
        "ne_comptera_pas"
      )
    )
  ) %>%
  
  ggplot() +
  
  geom_col(
    position = position_stack(
      reverse = TRUE
      ),
    colour = "black"
    ) +
  
  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(), 
    legend.position = "top",
    axis.title = element_blank(),
    legend.title = element_blank()
  ) +
  
  guides(
    fill = guide_legend(
      nrow = 2, 
      ncol = 2
    )
  ) +
  
  scale_y_discrete(
    labels = labels_lemonde
  ) +
  
  scale_fill_manual(
    labels = labels_lemonde_legende, # les labels sont ici
    values = scale_fill_lemonde # les couleurs sont ici
  )
Figure 12: Couleurs relevées sur l’original et libellés de légende réécrits.

Il faut encore afficher les pourcentages de réponses, le pourcentage le plus important de chaque ligne devant être en gras. J’avoue humblement avoir utilisé Claude pour m’aider ici.

Voir le code
sujets_2027_long %>%
  
  mutate(
    reponse = factor(
      reponse, 
      levels = c(
        "determinant",
        "important_pas_determinant",
        "secondaire",
        "ne_comptera_pas"
      )
    )
  ) %>%
  
  # Modifier les données, en markdown, en ajoutant deux étoiles ** pour afficher le maximum en gras à chaque fois
  group_by(sujet) %>%
  
  mutate(
    label_pct = if_else( # il faut une nouvelle colonne : on plot la colonne numérique, et on tire les labels d'une colonne character
      pct == max(pct),
      paste0("**", pct, "**"), # paste0 colle les strings, sans ajouter d'espace
      as.character(pct)
    )
  ) %>%
  
  ungroup() %>%
  
  ggplot() +
  
  geom_col(
    position = position_stack(
      reverse = TRUE
    ),
    colour = "black"
  ) +
  
  aes(
    x = pct, # on voit que x est pct (variable numérique)
    y = sujet, 
    fill = reponse
  ) +
  
  # Ajouter les labels ici
  geom_richtext( # geom_richtext() plutôt que geom_text(), pour gérer le markdown
    aes(
      label = label_pct # on voit que le label est label_pct (variable character)
      ), 
    position = position_stack(
      vjust = 0.5,
      reverse = TRUE
    ),
    label.color = NA, # retirer la petite boîte qui apparaît par défaut
    fill = NA, # ne pas remplir la petite boîte qui apparaît par défaut
    color = "white"
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(), 
    legend.position = "top",
    axis.title = element_blank(),
    legend.title = element_blank()
  ) +
  
  guides(
    fill = guide_legend(
      nrow = 2, 
      ncol = 2
    )
  ) +
  
  scale_y_discrete(
    labels = labels_lemonde
  ) +
  
  scale_fill_manual(
    labels = labels_lemonde_legende,
    values = scale_fill_lemonde
  )
Figure 13: Pourcentages affichés dans chaque segment, le maximum de chaque ligne en gras.

Régler le thème et les dimensions

Désormais, on s’attaque au dur, le thème du graphique. Pour ggplot2, le thème est le cœur du réacteur, qui permet de définir la position globale des éléments plutôt que le contenu, comme on l’a fait jusqu’ici.

Il faut :

  • Utiliser la bonne police d’écriture. Avec quelques recherches, j’ai trouvé une police qui ressemble fort à celle du Monde, Charter ;
  • Réduire les marges autour du graphique ;
  • Justifier le titre, le sous-titre, la légende et le caption à gauche ;
  • Retirer les lignes blanches verticales et horizontales en fond de graphique ;
  • Remplacer le fond gris par un fond blanc ;
  • Retirer l’affichage de l’axe des abscisses ;
  • Augmenter la taille des labels en ordonnée ;
  • Modifier les labels ordonnés pour que la police soit affichée en noir ;
  • Réduire les marges autour des labels en ordonnée au maximum ;
  • Retirer les petits tirets à côté des labels en ordonnée;
  • Modifier la forme des cases de la légende, qui sont plus proches du rectangle que du carré.

Enfin, je modifie la taille du plot, pour retrouver la proportion portrait de la figure originale (vous ne pourrez pas le voir au code, c’est directement un argument Quarto). Au-delà du ratio, cela permet aussi de faire en sorte que tous les titre, sous-titre, labels, etc… soient lisibles.

Pour que le plot soit réellement au plus proche de l’original, il faudrait certainement encore gérer finement la taille de police, passer les chiffres des réponses autres que Déterminant en noir, passer certains chiffres de la catégorie Il ne comptera pas du tout à droite du graphique… mais on va s’arrêter là.

Au final, on n’est pas parfaitement identique à la Figure 1, mais on n’est pas bien loin.

Voir le code
text_family <- "Charter"

sujets_2027_long %>%
  
  mutate(
    reponse = factor(
      reponse, 
      levels = c(
        "determinant",
        "important_pas_determinant",
        "secondaire",
        "ne_comptera_pas"
      )
    )
  ) %>%
  
  group_by(sujet) %>%
  
  mutate(
    label_pct = if_else(
      pct == max(pct),
      paste0("**", pct, "**"),
      as.character(pct)
    )
  ) %>%
  
  ungroup() %>%
  
  ggplot() +
  
  geom_col(
    position = position_stack(
      reverse = TRUE
    ),
    colour = "black"
  ) +
  
  aes(
    x = pct,
    y = sujet, 
    fill = reponse
  ) +
  
  geom_richtext(
    aes(
      label = label_pct
    ), 
    position = position_stack(
      vjust = 0.5,
      reverse = TRUE
    ),
    label.color = NA,
    fill = NA,
    color = "white",
    
    family = text_family # définir la police pour les pourcentages uniquement
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    text = element_text(
      family = text_family # définir la police dans le plot de façon générale
    ),
    
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(), 
    legend.position = "top",
    axis.title = element_blank(),
    legend.title = element_blank(),
    
    plot.margin = margin(5, 5, 5, 5), # réduire très fortement les marges
    
    plot.title.position = "plot", # justifier les titre et sous-titre à gauche
    plot.caption.position = "plot", # justifier le caption à gauche
    
    legend.location = "plot", # justifier la légende à gauche
    legend.justification = "left", # justifier la légende à gauche
    
    panel.grid = element_blank(), # retirer les lignes blanches horizontales et verticales en fond de plot
    
    panel.background = element_blank(), # remplacer le fond gris par un fond blanc
    
    axis.text.x = element_blank(), # retirer l'affichage de l'axe des abscisses
    axis.text.y = element_text(
      size = 10, # augmenter la taille des labels
      colour = "black", # afficher les labels ordonnés en noir
      margin = margin(0, -5, 0, 0) # réduire l'espace entre les labels en ordonnée et le plot
    ),
    axis.ticks = element_blank(), # retirer les petits tirets affichés à côté des labels en ordonnée
    
    legend.key.width = unit(10, units = "points") # réduire la largeur des cases de légende
  ) +
  
  guides(
    fill = guide_legend(
      nrow = 2, 
      ncol = 2
    )
  ) +
  
  scale_y_discrete(
    labels = labels_lemonde
  ) +
  
  scale_fill_manual(
    labels = labels_lemonde_legende,
    values = scale_fill_lemonde
  )
Figure 14: La version finale : police serif, fond blanc, marges réduites, format portrait.

Conclusion

D’abord, il est tout à fait possible de produire des graphiques d’une grande qualité en ggplot2. Je le savais déjà, notamment grâce au travail de Nicola Rennie et son livre The Art of Data Visualization with ggplot2. L’idée était ici de dépasser la seule connaissance du fait qu’il est possible de produire de bons visuels pour directement en (re)produire un.

La structure de base était simple à mettre en place. Le plus compliqué était (1) d’explorer l’ensemble des options de l’argument theme() et (2) de comprendre comment chercher, télécharger, installer, puis importer une police d’écriture pour l’utiliser avec ggplot2.

Je suis très content du résultat final et de ce que j’ai appris en chemin. Si l’exercice était un peu laborieux à réaliser, il serait bien plus simple à refaire aujourd’hui, en définissant directement un thème, comme ci-dessous.

theme_lemonde <- function(base_family = "Charter", base_size = 10) {
  theme(
    text = element_text(family = base_family),
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(),
    plot.title.position = "plot",
    plot.caption.position = "plot",
    legend.position = "top",
    legend.location = "plot",
    legend.justification = "left",
    legend.title = element_blank(),
    legend.key.width = unit(10, "points"),
    panel.grid = element_blank(),
    panel.background = element_blank(),
    axis.title = element_blank(),
    axis.ticks = element_blank(),
    axis.text.x = element_blank(),
    axis.text.y = element_text(size = base_size, colour = "black", margin = margin(0, -5, 0, 0)),
    plot.margin = margin(5, 5, 5, 5)
  )
}

Références

Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1‑23. https://doi.org/10.18637/jss.v059.i10
Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis. Springer-Verlag New York. https://ggplot2.tidyverse.org
Wilke, C. O., & Wiernik, B. M. (2022). ggtext: Improved Text Rendering Support for ’ggplot2’. https://doi.org/10.32614/CRAN.package.ggtext

Notes de bas de page

  1. C’est en gros un dataframe. Ce n’est pas exactement vrai, mais pas non plus trop faux. C’est très bien expliqué ici.↩︎

  2. Très souvent, en ggplot2, la réponse à la question “Comment fixer un affichage ?” revient à “Modifier les données” ou “Modifier l’ordre des facteurs.” Il y a cependant des exceptions (on en verra une juste après).↩︎

Code source
---
title: "Reproduire un graphique du Monde, en utilisant `ggplot2`"
image: img_display.png
image-alt: "Reproduction en ggplot2 du graphique du Monde sur les sujets prioritaires pour 2027"
date: 10-16-2026
categories: ["R", "Figure", "ggplot2"]
tags: ["Technique", "R"]
description: "Les infographies du Monde sont efficaces. Reproduisons l'une d'elles, étape par étape, en `ggplot2`."
lang: fr
body-classes: indent-paragraphs
format:
  html:
    code-fold: true
    code-summary: "Voir le code"
    code-overflow: wrap
    code-tools: true
    code-block-bg: true
execute:
  warning: false
  error: false
draft: false
---

<hr style="border:1px solid blue" />

# Point de départ
Les graphistes du Monde sont très fortiches, en réalisant de belles représentations graphiques de données autrement relativement indigestes. Par exemple, l'article [*Présidentielle 2027 : la santé et le pouvoir d’achat, principales préoccupations des électeurs à un an du scrutin*](https://www.lemonde.fr/politique/article/2026/04/13/presidentielle-2027-au-centre-des-preoccupations-des-francais-la-sante-et-le-pouvoir-d-achat_6679656_823448.html){target='_blank'} représente des résultats issus d'une enquête électorale auprès de 10 962 personnes sur les thèmes prioritaires pour l'élection présidentielle de 2027.

Le premier graphique de cet article est le suivant :

![Les sujets prioritaires pour la présidentielle de 2027, selon l'enquête électorale Ipsos BVA-CESI École d'ingénieurs, mise en forme par [Le Monde](https://www.lemonde.fr/politique/article/2026/04/13/presidentielle-2027-au-centre-des-preoccupations-des-francais-la-sante-et-le-pouvoir-d-achat_6679656_823448.html){target='_blank'}.](Sujets.jpg){#fig-sujets-2027 width="60%" fig-align="center"}

Je sais pas vous, mais moi, je le trouve efficace. Donc, on va essayer de le reproduire en `R`, étape par étape.

Pour chaque étape, l'idée est de reproduire le graphique, *même si les proportions ne sont pas bonnes*. On gérera les dimensions à la toute dernière étape.

# Reproduire le graphique
## Préparer les données
### Extraire les données
La première étape est de disposer des données. Ici, rien de bien compliqué. On regarde ligne après ligne, et on en fait un tribble^[C'est en gros un dataframe. Ce n'est pas exactement vrai, mais pas non plus trop faux. C'est très bien expliqué [ici](https://tibble.tidyverse.org/){target='_blank'}.].

```{r}
#| label: tbl-dfprezmessy
#| tbl-cap: "Le jeu de données messy ☹️."

library(tidyverse) # le package tibble fait partie du tidyverse
library(knitr) # pour afficher les données en une table

# Extraire les données
sujets_2027 <- tribble(
  ~sujet, ~determinant, ~important_pas_determinant, ~secondaire, ~ne_comptera_pas,
  "sante", 76, 19, 3, 2,
  "pouvoirdachat", 66, 27, 5, 2, 
  "travailpaie", 63, 30, 5, 2,
  "systemeeducatif", 56, 33, 8, 3,
  "securite", 53, 32, 11, 4,
  "dette", 51, 34, 10, 5,
  "attractivite", 50, 37, 9, 4,
  "immigration", 49, 24, 15, 12,
  "place", 42, 39, 14, 5,
  "chomage", 41, 45, 10, 4,
  "impotstaxes", 41, 38, 14, 7
)

kable(sujets_2027) # afficher les données
```

On a les données, c'est très bien. Mais voilà, elles ne sont pas tidy [@wickham_tidy]. *Tidy*, littéralement propre, rangé, est un format standardisé de données. L'idée est que des données tidy sont utilisables par `ggplot2`, à l'opposé de données *messy* (littéralement désordonnées, en bazar), qui ne le sont pas. Le format repose sur trois principes de base : 

1. Chaque variable est une colonne;
2. Chaque observation est une ligne;
3. Chaque type d'observation est une table.

Ici, une même variable (le pourcentage de réponses) se retrouve dans quatre colonnes différentes, chaque ligne n'est pas une observation mais les réponses par question, en bref, c'est le bazar, c'est *messy*, et on va le *tidy*.

### Pivoter le jeu

Pour ce faire, on fait pivoter le jeu. 

On en profite également pour fixer l'ordre des facteurs de façon décroissante, pour que le graphique affiche les données du plus gros au plus petit pourcentage plutôt que de façon alphabétique^[Très souvent, en `ggplot2`, la réponse à la question "Comment fixer un affichage ?" revient à "Modifier les données" ou "Modifier l'ordre des facteurs." Il y a cependant des exceptions (on en verra une juste après).].

Je n'affiche que les 15 premières lignes.

```{r}
#| label: tbl-dfpreztidy
#| tbl-cap: "Le jeu de données tidy 😀."

sujets_2027_long <- sujets_2027 %>%
  
  mutate(
    sujet = fct_reorder(
    sujet, 
    determinant
    )
  ) %>%  # arranger la colonne sujet, en fonction de la colonne determinant
  
  pivot_longer(
    cols = -sujet, # pas besoin de la faire pivoter, on la garde telle quelle
    names_to = "reponse", # les colonnes pivotées finissent ici
    values_to = "pct" # les valeurs pivotées finissent là
  )

sujets_2027_long %>%
  head(n = 15) %>% # afficher les 15 premières lignes
  kable()
```

Désormais, chaque variable est bien une colonne et chaque ligne est bien une observation. On peut travailler.

## Préparer le graphique

Première étape, réfléchir en `R` et en `ggplot2` [@ggplot2wickham]. 

D'abord, `R` est un langage dit "orienté objet." On va donc créer un objet (un plot), qui appellera lui-même des objets pour sa construction (le titre du plot, le sous-titre, etc...).

Ensuite, en grammaire `ggplot2`, les graphiques sont des couches, et il faut bien réfléchir à l'ordre dans lequel le code est écrit (pour que les couches se superposent dans le bon ordre).

### Poser la structure

On pose un fond, en appelant la fonction, puis on définit notre usage de base, des petits bâtons, c'est-à-dire des colonnes.

```{r}
#| label: fig-plot0
#| fig-cap: "Le squelette : des colonnes grises, sans couleur ni texte. C'est pas grand chose, mais c'est un début."
#| out-width: "100%"
#| fig-width: 7
#| fig-height: 5
#| fig-align: "center"

sujets_2027_long %>% # partir des données
  
  ggplot() + # appeler ggplot()
  
  geom_col() + # définir un diagramme en barres
  
  aes(
    x = pct, # définir l'axe x en abscisse (le pourcentage de réponses) 
    y = sujet # définir l'axe y en ordonnée (la question posée)
  )
```

Voilà : les bases sont posées. Le seul problème structurel est la ligne *Lutter contre le chômage*, qui est en dernière, alors que c'est la ligne *Baisser le niveau des impôts et des taxes* dans la @fig-sujets-2027 (les deux lignes sont à 41 % de réponses jugées *Déterminantes*).

Si on voulait une copie *parfaitement conforme*, on devrait ordonner les données manuellement plutôt qu'automatiquement. Ici, mon but est plutôt de suivre une logique d'automatisation, pour obtenir un graphique qui ordonne lui-même les réponses de façon descendante. Donc, je ne vais pas le modifier manuellement.

J'ajoute désormais deux choses. D'abord, la couleur, en fonction de la réponse donnée. Ensuite, chaque réponse donnée est entourée d'un liseré noir comme sur le graphique original.

```{r}
#| label: fig-plot1
#| fig-cap: "Couleur par modalité de réponse et liseré noir autour de chaque segment. Les modalités sont encore dans le mauvais ordre."
#| out-width: "100%"
#| fig-width: 7
#| fig-height: 5
#| fig-align: "center"

sujets_2027_long %>%
  
  ggplot() +
  
  geom_col(
    colour = "black" # ajouter un liseré noir autour des colonnes
    ) +
  
  aes(
    x = pct, 
    y = sujet,
    fill = reponse # colorer les barres, en fonction des modalités de réponse
  )
```

Premier problème, les modalités de réponse ne sont pas dans le bon ordre. Plutôt que d'arranger/ordonner le facteur, comme on l'a fait juste au-dessus, on va spécifier un argument précisant d'inverser l'ordre d'affichage des réponses.

```{r}
#| label: fig-plot2
#| fig-cap: "Les segments sont empilés dans l'ordre de la légende grâce à `position_stack(reverse = TRUE)`."
#| out-width: "100%"
#| fig-width: 7
#| fig-height: 5
#| fig-align: "center"

sujets_2027_long %>%
  
  ggplot() +
  
  geom_col(
    position = position_stack(
      reverse = TRUE # reverse = TRUE est assez explicite
      ),
    colour = "black"
    ) +
  
  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  )
```

### Ajouter les textes : titre, sous-titre et caption

On ajoute le titre, sous-titre, la note, en respectant la logique d'objet de `R`. On voit qu'ils dépassent largement le cadre du plot. On solutionnera ça à la prochaine étape.

```{r}
#| label: fig-plot3
#| fig-cap: "Titre, sous-titre et source ajoutés. Ils débordent du cadre, c'est réglé à l'étape suivante."
#| out-width: "100%"
#| fig-width: 7
#| fig-height: 5
#| fig-align: "center"

title_lemonde <- "Les sujets prioritaires pour 2027"
subtitle_lemonde <- "Pour chacun des sujets suivants, diriez-vous qu'il sera, dans votre choix de vote pour l'élection présidentielle de 2027... en % des réponses"
caption_lemonde <- "Enquête électorale française 2026, Ipsos BVA-CESI École d'ingénieurs pour Sciences Po Cevipof, la Fondation Jean Jaurès et Le Monde. Sondage effectué par Internet du 2 au 9 avril 2026, sur un échantillon de 10 962 personnes inscrites sur les listes électorales. Infographie Le Monde; reproduite pour de la vulgarisation technique."

sujets_2027_long %>%
  
  ggplot() +

  geom_col(
    position = position_stack(
      reverse = TRUE
      ),
    colour = "black"
    ) +
  
  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  )  +
  
  labs(
    title = title_lemonde, 
    subtitle = subtitle_lemonde,
    caption = caption_lemonde
  )
```

Désormais, il faut formater le sous-titre et le caption, qui incluent du gras et de l'italique. On va utiliser le package `ggtext` [@ggtextwilke], qui permet d'incorporer du markdown et du html dans les textes.

Cela va aussi résoudre le problème de longueur, en gérant automatiquement les renvois à la ligne.

```{r}
#| label: fig-plot4
#| fig-cap: "Retours à la ligne automatiques, gras et italique dans les textes avec `ggtext`. La légende est encore à droite."
#| out-width: "100%"
#| fig-width: 7
#| fig-height: 5
#| fig-align: "center"

library(ggtext)

title_lemonde_ggtext <- "**Les sujets prioritaires pour 2027**"
subtitle_lemonde_ggtext <- "Pour chacun des sujets suivants, **diriez-vous qu'il sera, dans votre choix de vote pour l'élection présidentielle de 2027...** *en % des réponses*"
caption_lemonde_ggtext <- "Enquête électorale française 2026, Ipsos BVA-CESI École d'ingénieurs pour Sciences Po Cevipof, la Fondation Jean Jaurès et *Le Monde*.<br>Sondage effectué par Internet du 2 au 9 avril 2026, sur un échantillon de 10 962 personnes inscrites sur les listes électorales.<br>Infographie *Le Monde*; reproduite pour de la vulgarisation technique."

sujets_2027_long %>%

  ggplot() +

  geom_col(
    position = position_stack(
      reverse = TRUE
      ),
    colour = "black"
    ) +

  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple()
  )
```

Ce qui est entre *une* étoile est en italique, entre *deux* étoiles est en gras. Les balises `<br>` sont un retour à la ligne, en html, que `ggplot2` ne reconnaît pas nativement (d'où l'utilisation de `ggtext`). Cela commence à globalement prendre forme.

### Placer et ordonner la légende

La légende est mal positionnée, il nous faut la remonter au-dessus des réponses.

```{r}
#| label: fig-plot5
#| fig-cap: "La légende passe au-dessus du graphique, sur une seule ligne."
#| out-width: "100%"
#| fig-width: 7
#| fig-height: 5
#| fig-align: "center"

sujets_2027_long %>%

  ggplot() +
  
  geom_col(
    position = position_stack(
      reverse = TRUE
      ),
    colour = "black"
    ) +

  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(), 
    legend.position = "top" # Bien positionnée
  )
```

Cette légende est une ligne, on souhaite une grille 2x2.

```{r}
#| label: fig-plot6
#| fig-cap: "La légende est disposée en grille deux par deux. Presque : l'ordre des modalités ne suit pas encore celui des barres."
#| out-width: "100%"
#| fig-width: 7
#| fig-height: 5
#| fig-align: "center"

sujets_2027_long %>%

  ggplot() +

  geom_col(
    position = position_stack(
      reverse = TRUE
      ),
    colour = "black"
    ) +
  
  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(), 
    legend.position = "top"
  ) +
  
  guides(
    fill = guide_legend(
      nrow = 2, 
      ncol = 2
    )
  )
```

Problème supplémentaire, la légende n'est pas bien ordonnée. En `R`, les catégories sont par défaut présentées par ordre alphabétique. Il faut donc fixer l'ordre des facteurs. 

```{r}
#| label: fig-plot7
#| fig-cap: "Les niveaux du facteur `reponse` sont fixés : la légende suit enfin l'ordre des segments."
#| out-width: "100%"
#| fig-width: 7
#| fig-height: 5
#| fig-align: "center"

sujets_2027_long %>%
  
  mutate(
    reponse = factor(
      reponse, 
      levels = c(
        "determinant",
        "important_pas_determinant",
        "secondaire",
        "ne_comptera_pas"
      )
    )
  ) %>%
  
  ggplot() +
  
  geom_col(
    position = position_stack(
      reverse = TRUE
      ),
    colour = "black"
    ) +
  
  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(), 
    legend.position = "top"
  ) +
  
  guides(
    fill = guide_legend(
      nrow = 2, 
      ncol = 2
      )
  )
```

### Retirer les titres d'axes et renommer les sujets

Étape suivante, le graphique initial ne nomme pas ses axes ou la légende. On les retire.

```{r}
#| label: fig-plot8
#| fig-cap: "Titres des axes et de la légende retirés, comme sur l'original."
#| out-width: "100%"
#| fig-width: 7
#| fig-height: 5
#| fig-align: "center"

sujets_2027_long %>%
    
  mutate(
    reponse = factor(
      reponse, 
      levels = c(
        "determinant",
        "important_pas_determinant",
        "secondaire",
        "ne_comptera_pas"
      )
    )
  ) %>%

  ggplot() +
  
  geom_col(
    position = position_stack(
      reverse = TRUE
      ),
    colour = "black"
    ) +
 
  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(), 
    legend.position = "top",
    axis.title = element_blank(), # retirer les titres des axes
    legend.title = element_blank() # retirer le titre de la légende
  ) +
  
  guides(
    fill = guide_legend(
      nrow = 2, 
      ncol = 2
      )
  )
```

On commence à avoir, globalement, reproduit la *structure* de la figure initiale. Il manque beaucoup de choses cependant, comme la police d'écriture, les couleurs, renommer les labels en ordonnée, la position des titre, sous-titre et de la légende, le fond du plot... continuons donc par les labels en ordonnée.

À nouveau, en respectant la logique d'objet de `R`.

```{r}
#| label: fig-plot9
#| fig-cap: "Les sujets en ordonnée reçoivent leur libellé complet, avec les mêmes retours à la ligne que Le Monde."
#| out-width: "100%"
#| fig-width: 7
#| fig-height: 5
#| fig-align: "center"

labels_lemonde <- c(
  sante = "Préserver le système\nde santé",
  pouvoirdachat = "Améliorer le pouvoir\nd'achat des Français",
  travailpaie = "Faire en sorte que\nle travail paie davantage",
  systemeeducatif = "Améliorer le système\néducatif",
  securite = "Assurer une meilleure sécurité\ndes biens et des personnes",
  dette = "Réduire la dette et les déficits",
  attractivite = "Améliorer l'attractivité\nde l'économie française",
  immigration = "Mieux maîtriser\nl'immigration",
  place = "Maintenir la place\nde la France dans le monde",
  chomage = "Lutter contre\nle chômage",
  impotstaxes = "Baisser le niveau\ndes impôts et des taxes"
)

sujets_2027_long %>%
  
  mutate(
    reponse = factor(
      reponse, 
      levels = c(
        "determinant",
        "important_pas_determinant",
        "secondaire",
        "ne_comptera_pas"
      )
    )
  ) %>%

  ggplot() +

  geom_col(
    position = position_stack(
      reverse = TRUE
      ),
    colour = "black"
    ) +
  
  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(), 
    legend.position = "top",
    axis.title = element_blank(),
    legend.title = element_blank()
  ) +
  
  guides(
    fill = guide_legend(
      nrow = 2, 
      ncol = 2
    )
  ) +
  
  scale_y_discrete(
    labels = labels_lemonde # modifier les labels en ordonnée, en respectant les retours à la ligne de la figure initiale
  )
```

Les balises `\n` sont un retour à la ligne classique, que `ggplot2` reconnaît nativement (contrairement à `<br>`, qui est un retour à la ligne en html).

### Colorer et afficher les pourcentages

Toujours simple, les couleurs. Je m'aide de la pipette de Paint pour les identifier et les définir manuellement.

Aussi, les labels de la légende ne sont pas propres, il faut les modifier.

```{r}
#| label: fig-plot10
#| fig-cap: "Couleurs relevées sur l'original et libellés de légende réécrits."
#| out-width: "100%"
#| fig-width: 7
#| fig-height: 5
#| fig-align: "center"

labels_lemonde_legende <- c(
  "Déterminant",
  "Important mais\npas déterminant",
  "Secondaire",
  "Il ne comptera\npas du tout"
)

scale_fill_lemonde <- c(
  "#357BAC",
  "#85B8D6",
  "#EDBFC0",
  "#D4385D"
  )

sujets_2027_long %>%
  
  mutate(
    reponse = factor(
      reponse, 
      levels = c(
        "determinant",
        "important_pas_determinant",
        "secondaire",
        "ne_comptera_pas"
      )
    )
  ) %>%
  
  ggplot() +
  
  geom_col(
    position = position_stack(
      reverse = TRUE
      ),
    colour = "black"
    ) +
  
  aes(
    x = pct, 
    y = sujet, 
    fill = reponse
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(), 
    legend.position = "top",
    axis.title = element_blank(),
    legend.title = element_blank()
  ) +
  
  guides(
    fill = guide_legend(
      nrow = 2, 
      ncol = 2
    )
  ) +
  
  scale_y_discrete(
    labels = labels_lemonde
  ) +
  
  scale_fill_manual(
    labels = labels_lemonde_legende, # les labels sont ici
    values = scale_fill_lemonde # les couleurs sont ici
  )
```

Il faut encore afficher les pourcentages de réponses, le pourcentage le plus important de chaque ligne devant être en gras. J'avoue humblement avoir utilisé Claude pour m'aider ici.

```{r}
#| label: fig-plot11
#| fig-cap: "Pourcentages affichés dans chaque segment, le maximum de chaque ligne en gras."
#| out-width: "100%"
#| fig-width: 7
#| fig-height: 5
#| fig-align: "center"

sujets_2027_long %>%
  
  mutate(
    reponse = factor(
      reponse, 
      levels = c(
        "determinant",
        "important_pas_determinant",
        "secondaire",
        "ne_comptera_pas"
      )
    )
  ) %>%
  
  # Modifier les données, en markdown, en ajoutant deux étoiles ** pour afficher le maximum en gras à chaque fois
  group_by(sujet) %>%
  
  mutate(
    label_pct = if_else( # il faut une nouvelle colonne : on plot la colonne numérique, et on tire les labels d'une colonne character
      pct == max(pct),
      paste0("**", pct, "**"), # paste0 colle les strings, sans ajouter d'espace
      as.character(pct)
    )
  ) %>%
  
  ungroup() %>%
  
  ggplot() +
  
  geom_col(
    position = position_stack(
      reverse = TRUE
    ),
    colour = "black"
  ) +
  
  aes(
    x = pct, # on voit que x est pct (variable numérique)
    y = sujet, 
    fill = reponse
  ) +
  
  # Ajouter les labels ici
  geom_richtext( # geom_richtext() plutôt que geom_text(), pour gérer le markdown
    aes(
      label = label_pct # on voit que le label est label_pct (variable character)
      ), 
    position = position_stack(
      vjust = 0.5,
      reverse = TRUE
    ),
    label.color = NA, # retirer la petite boîte qui apparaît par défaut
    fill = NA, # ne pas remplir la petite boîte qui apparaît par défaut
    color = "white"
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(), 
    legend.position = "top",
    axis.title = element_blank(),
    legend.title = element_blank()
  ) +
  
  guides(
    fill = guide_legend(
      nrow = 2, 
      ncol = 2
    )
  ) +
  
  scale_y_discrete(
    labels = labels_lemonde
  ) +
  
  scale_fill_manual(
    labels = labels_lemonde_legende,
    values = scale_fill_lemonde
  )
```

### Régler le thème et les dimensions

Désormais, on s'attaque au dur, le [thème](https://ggplot2.tidyverse.org/reference/theme.html){target='_blank'} du graphique. Pour `ggplot2`, le thème est le cœur du réacteur, qui permet de définir la position globale des éléments plutôt que le contenu, comme on l'a fait jusqu'ici.

Il faut : 

- Utiliser la bonne police d'écriture. Avec quelques recherches, j'ai trouvé une police qui ressemble fort à celle du Monde, *Charter* ;
- Réduire les marges autour du graphique ;
- Justifier le titre, le sous-titre, la légende et le caption à gauche ;
- Retirer les lignes blanches verticales et horizontales en fond de graphique ;
- Remplacer le fond gris par un fond blanc ;
- Retirer l'affichage de l'axe des abscisses ;
- Augmenter la taille des labels en ordonnée ;
- Modifier les labels ordonnés pour que la police soit affichée en noir ;
- Réduire les marges autour des labels en ordonnée au maximum ;
- Retirer les petits tirets à côté des labels en ordonnée;
- Modifier la forme des cases de la légende, qui sont plus proches du rectangle que du carré.

Enfin, je modifie la taille du plot, pour retrouver la proportion portrait de la figure originale (vous ne pourrez pas le voir au code, c'est directement un argument Quarto). Au-delà du ratio, cela permet aussi de faire en sorte que tous les titre, sous-titre, labels, etc... soient lisibles.

Pour que le plot soit réellement au plus proche de l'original, il faudrait certainement encore gérer finement la taille de police, passer les chiffres des réponses autres que *Déterminant* en noir, passer certains chiffres de la catégorie *Il ne comptera pas du tout* à droite du graphique... mais on va s'arrêter là. 

Au final, on n'est pas parfaitement identique à la @fig-sujets-2027, mais on n'est pas bien loin.

```{r}
#| label: fig-plot12
#| fig-cap: "La version finale : police serif, fond blanc, marges réduites, format portrait."
#| out-width: "60%"
#| fig-width: 4.5
#| fig-height: 7
#| fig-align: "center"
#| dev: ragg_png
#| fig-dpi: 600

text_family <- "Charter"

sujets_2027_long %>%
  
  mutate(
    reponse = factor(
      reponse, 
      levels = c(
        "determinant",
        "important_pas_determinant",
        "secondaire",
        "ne_comptera_pas"
      )
    )
  ) %>%
  
  group_by(sujet) %>%
  
  mutate(
    label_pct = if_else(
      pct == max(pct),
      paste0("**", pct, "**"),
      as.character(pct)
    )
  ) %>%
  
  ungroup() %>%
  
  ggplot() +
  
  geom_col(
    position = position_stack(
      reverse = TRUE
    ),
    colour = "black"
  ) +
  
  aes(
    x = pct,
    y = sujet, 
    fill = reponse
  ) +
  
  geom_richtext(
    aes(
      label = label_pct
    ), 
    position = position_stack(
      vjust = 0.5,
      reverse = TRUE
    ),
    label.color = NA,
    fill = NA,
    color = "white",
    
    family = text_family # définir la police pour les pourcentages uniquement
  ) +
  
  labs(
    title = title_lemonde_ggtext, 
    subtitle = subtitle_lemonde_ggtext,
    caption = caption_lemonde_ggtext
  ) +
  
  theme(
    text = element_text(
      family = text_family # définir la police dans le plot de façon générale
    ),
    
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(), 
    legend.position = "top",
    axis.title = element_blank(),
    legend.title = element_blank(),
    
    plot.margin = margin(5, 5, 5, 5), # réduire très fortement les marges
    
    plot.title.position = "plot", # justifier les titre et sous-titre à gauche
    plot.caption.position = "plot", # justifier le caption à gauche
    
    legend.location = "plot", # justifier la légende à gauche
    legend.justification = "left", # justifier la légende à gauche
    
    panel.grid = element_blank(), # retirer les lignes blanches horizontales et verticales en fond de plot
    
    panel.background = element_blank(), # remplacer le fond gris par un fond blanc
    
    axis.text.x = element_blank(), # retirer l'affichage de l'axe des abscisses
    axis.text.y = element_text(
      size = 10, # augmenter la taille des labels
      colour = "black", # afficher les labels ordonnés en noir
      margin = margin(0, -5, 0, 0) # réduire l'espace entre les labels en ordonnée et le plot
    ),
    axis.ticks = element_blank(), # retirer les petits tirets affichés à côté des labels en ordonnée
    
    legend.key.width = unit(10, units = "points") # réduire la largeur des cases de légende
  ) +
  
  guides(
    fill = guide_legend(
      nrow = 2, 
      ncol = 2
    )
  ) +
  
  scale_y_discrete(
    labels = labels_lemonde
  ) +
  
  scale_fill_manual(
    labels = labels_lemonde_legende,
    values = scale_fill_lemonde
  )
```

# Conclusion

D'abord, il est tout à fait possible de produire des graphiques d'une grande qualité en `ggplot2`. Je le savais déjà, notamment grâce au travail de Nicola Rennie et son livre [The Art of Data Visualization with ggplot2](https://nrennie.rbind.io/art-of-viz/){target='_blank'}. L'idée était ici de dépasser la seule connaissance du fait qu'il est possible de produire de bons visuels pour directement en (re)produire un. 

La structure de base était simple à mettre en place. Le plus compliqué était (1) d'explorer l'ensemble des options de l'argument `theme()` et (2) de comprendre comment chercher, télécharger, installer, puis importer une police d'écriture pour l'utiliser avec `ggplot2`.

Je suis très content du résultat final et de ce que j'ai appris en chemin. Si l'exercice était un peu laborieux à réaliser, il serait bien plus simple à refaire aujourd'hui, en définissant directement un thème, comme ci-dessous.

```{r}
#| code-fold: FALSE

theme_lemonde <- function(base_family = "Charter", base_size = 10) {
  theme(
    text = element_text(family = base_family),
    plot.title = element_textbox_simple(),
    plot.subtitle = element_textbox_simple(),
    plot.caption = element_textbox_simple(),
    plot.title.position = "plot",
    plot.caption.position = "plot",
    legend.position = "top",
    legend.location = "plot",
    legend.justification = "left",
    legend.title = element_blank(),
    legend.key.width = unit(10, "points"),
    panel.grid = element_blank(),
    panel.background = element_blank(),
    axis.title = element_blank(),
    axis.ticks = element_blank(),
    axis.text.x = element_blank(),
    axis.text.y = element_text(size = base_size, colour = "black", margin = margin(0, -5, 0, 0)),
    plot.margin = margin(5, 5, 5, 5)
  )
}

```


# Références